
画像生成AI比較【2026年10月更新】ChatGPT Images 2.5とNano Banana 2.1、LP・SNS・バナー制作ではどう選ぶか
更新日:10月9日

最終更新:2026年10月7日/実測記録:2026年9月9日
結論:HSビルの9月の3課題では、ChatGPT Images 2.5が最も少ない人間介入で完成に近い画像へ到達しました。Nano Banana 2.1は、HSビルの現行利用環境ではまだ実機検証ができていません。当面はChatGPTを主力として使い、2.1は公式情報で確認できる改善点と料金を整理する段階です。
この記事は、LP・SNS・バナーなど「公開できる制作物」が必要な中小企業の経営者、広報、マーケ担当の方向けです。2026年10月7日時点で確認した公式情報と、2026年9月9日に実施したHSビルの実験を、別の種類の情報として分けて整理しています。
2026年10月7日追記:HSビルの現行利用環境では、Nano Banana 2.1を使った検証をまだ実施できていません。以下の2.1の情報は公式資料に基づく整理です。日本全体で利用できない、または性能が低いという意味ではありません。
2026年10月の更新点と、この比較の読み方
2026年10月に、GoogleがNano Banana 2.1を発表しました。これを受け、この記事に公式情報と料金の読み方を追加しました。2026年9月9日の実験の記録は、日付と内容をそのまま残しています。
なお、この記事に出てくる情報は次の4種類に分けています。
・公式仕様: 各社の公開ドキュメントに書かれた機能と料金
・ベンダー社内評価: 各社が自社で行った評価。他社の指標とは比較できません
・HSビルの観察: 9月9日にHSビルが実際に試した結果
・今後の検証計画:Nano Banana 2.1をHSの環境で実際に利用できるようになってから実施する追加比較。現在は保留です。
用途から判断する:利用中のモデルと新モデルの公式情報を分けて読む
状況 | 今の判断 | 根拠の種類 |
すでにChatGPT Images 2.5で素材を作れている | 今の制作工程を継続し、困っている用途に絞って比較する。 | HS観察(9月9日、3課題の範囲) |
日本語入りバナーの修正回数が多い | まず現在使えるモデルで文字の誤り・修正工数を記録する。2.1の比較は利用可能になるまで保留。 | 公式仕様+HS未検証 |
参照画像からキャラクターを複数出したい | 2.1は公式仕様を確認する段階。HSでの同一素材による検証は、利用可能になってから。 | 公式仕様(上限は保証ではありません) |
API利用でコストを抑えたい | 公式の単価と実際の請求を分けて確認する。使えるモデルで少量検証し、2.1は利用環境の確認後に行う。 | 公式料金 |
素材を自分で完成できる | 現在のツールのままで構いません。外注は必須ではありません。 | 編集方針 |
公開物の品質・期限・素材管理が不安 | 制作範囲を確認する選択肢があります。 | CTA参照 |
Nano Banana 2.1とChatGPT Images 2.5の公式情報
Nano Banana 2.1:編集と一貫性の公式改善
Googleのモデル資料によると、安定IDは gemini-nano-banana-2.1 です。Nano Banana 2の後継にあたる効率重視のモデルで、Nano Banana Proに対する位置づけとされています。Google公式モデル資料で確認した主な仕様は次のとおりです。
・出力サイズは1K(標準)、2K、4K
・参照画像は最大14枚
・一貫性の目安は、キャラクター最大4人、物体最大10個
・ウェブ検索と画像による根拠づけ(グラウンディング)に対応
・思考レベルは minimal / medium(標準) / high
ここで大事なのは、これらが「対応している機能やメーカーが示す上限」であって、あらゆる場面での精度の保証ではないという点です。
Google DeepMindモデルカード(2026年10月6日公開)によると、Gemini 3.6 Flashがベースです。Google社内の人手評価では、マスクやインクによる編集、複数キャラクターの一貫性などで改善が報告されています。ただしこれはGoogle社内評価です。他社のリーダーボードや、OpenAIの評価のElo値と並べて比べることはできません。
Googleは制約も明記しています。
・小さい文字や長い文字
・キャラクターのずれ
・指示が不完全な編集
・ポーズが残る問題
・空間の取り違え
日本語バナーでは文字の扱いが重要なので、この制約は実際に確認する価値があります。
ChatGPT Images 2.5:HSの主力とAPIモデルの違い
ここで区別が必要です。OpenAIのAPIドキュメントにある gpt-image-2.5 ファミリーはAPI側のモデルで、
ChatGPT Imagesは製品としての画面です。
OpenAIのSunburst資料とFlare資料では、2種類のモデルが案内されています。
・Sunburst(正確なAPI ID:gpt-image-2.5-sunburst、スナップショット -2026-09-08):テキストと画像を入力して画像を出力します。編集の精度を重視する位置づけです。品質設定は low / medium / high / xhigh / max / auto です。
・Flare(gpt-image-2.5-flare):速くて品質の高い、日常的な生成向けという位置づけです。別のモデルです。
OpenAIの画像生成ツールガイドでは、精密な編集にはSunburst、速い生成にはFlareが案内されています。生成と会話形式の編集は、Responsesのツールで使えます。
HSビルがChatGPTの画面で使っていた画像生成が、裏でどのAPIモデルだったかは、画面の結果からは特定できません。そのため、この記事ではAPIモデル名と画面での体験を同一視しません。
API料金比較:画像出力の単価と、完成までの総コスト
Googleの公式API料金(画像出力のみ、標準料金)は、Nano Banana 2.1で1Kが0.0336ドル、2Kが0.0504ドル、4Kが0.113ドルです。バッチ処理では0.0168 / 0.0252 / 0.0567ドルです。
旧Nano Banana 2の標準料金は、画像出力のみでおよそ0.067 / 0.101 / 0.151ドルでした。比べると、1Kと2Kは約50%安く、4Kは約25%安くなっています。一方で、入力は100万トークンあたり1.50ドル、テキストと思考の出力は7.50ドルで、この部分のコストは上がっています。そのため「総コストが半分になる」とは言えません。
項目 | Nano Banana 2.1(Google) | gpt-image-2.5(OpenAI) |
画像出力 | 1K 0.0336ドル/2K 0.0504ドル/4K 0.113ドル(1枚、標準) | 100万トークンあたり30ドル(標準)/15ドル(バッチ) |
入力 | 100万トークンあたり1.50ドル | 画像8ドル/テキスト5ドル(100万トークンあたり) |
1枚あたりの料金 | 公式表に記載あり | GPT Image 2用の公式計算機を2.5の見積もりに使えない |
OpenAIの公式資料は、GPT Image 2用の計算機では2.5のトークン消費は見積もれない、としています。画像出力のトークン単価が同じでも、1枚あたりの請求が同じとは限りません。この表の単価だけでは、両社の1枚あたりの総請求額の優劣は決められません。実際の利用量と請求を確認する必要があります。
また、これはAPIの料金です。GeminiアプリやChatGPTの月額プランの料金ではありません。円換算もしていません。
画像出力の単価が安くても、誤字や人物のずれを直す回数が増えると制作費は変わります。実務では、モデル利用料に加え、担当者の確認・修正・仕上げの時間も記録します。APIの請求額、アプリの契約料、人が手を動かした時間をそれぞれ分けると、少ない枚数でも自社の判断材料になります。
旧モデルの終了予定は公式で確認する
旧モデル gemini-3.1-flash-image については、Googleの終了予定一覧で、2026年10月7日時点の終了日の発表を確認できませんでした。乗り換えの期限は、報道やSNSの投稿だけで決めず、公式の終了予定を確認してください。
HSビルの実測比較:2026年9月9日の記録
以下は2026年9月9日に実施した、HSビルの過去の実験記録です。 画面操作での実務検証であり、APIで条件を固定したベンチマークではありません。ここにはNano Banana 2.1は含まれていません。旧Nano Banana Proの結果は、2.1に引き継ぎません。
3モデルの判断表:今回の実務条件ならどう選ぶか
モデル | 今回強かった点 | 今回確認した弱点・注意点 | HSビルの判断 |
ChatGPT Images 2.5 | 複合指示の理解、人物一貫性、日本語B2B画像、図解、低い追加指示負荷 | 指定外の細部まで完全固定するピクセル単位編集では再生成が残る | 今回の3テストでは第一候補 |
Seedream 5.0 Pro | シンプルで落ち着いた構成、日本語主要文言の安定感 | 1回の長文指示で一式を返せず、TEST1では4回の人間指示が必要 | デザイン探索や簡潔な構成では候補、複合工程は要確認 |
Nano Banana Pro | 比較らしい構図や情報量を出す場面 | 人物参照の再現、不要文字、誤字・余計な評価文で人間確認が増えた | 今回条件では自動完成よりHuman Gate前提 |
判断を一言でまとめると、「どれが一番きれいか」より「何回人が直せば仕事として完成するか」で選ぶ方が実務に近い、というのが今回の結論です。
検証方法:同じ素材・同じ意味の指示で3つの仕事を試した
同じ基準人物画像を使う
モデルごとに有利になるようプロンプトを書き換えない
日本語の掲載文言は同一にする
可能な範囲で同じ比率・同じ用途を指定する
失敗出力を隠さない
直接比較できない機能差は無理に点数化しない
1回の当たり画像だけで勝者を決めない
人間の追加指示回数・修正負荷を評価に含める
TEST 1:人物一貫性と複合指示
基準人物を維持しながら、服装、背景、構図を段階的に変える仕事です。
TEST 2:日本語B2Bブログサムネ
「画像生成AIは仕事でどれを選ぶ?」「同じ実務プロンプトで比較」「人物・日本語・図解・修正工数」という日本語を含む、16:9の企業向けサムネを作らせました。
TEST 3:業務図解・フライヤー
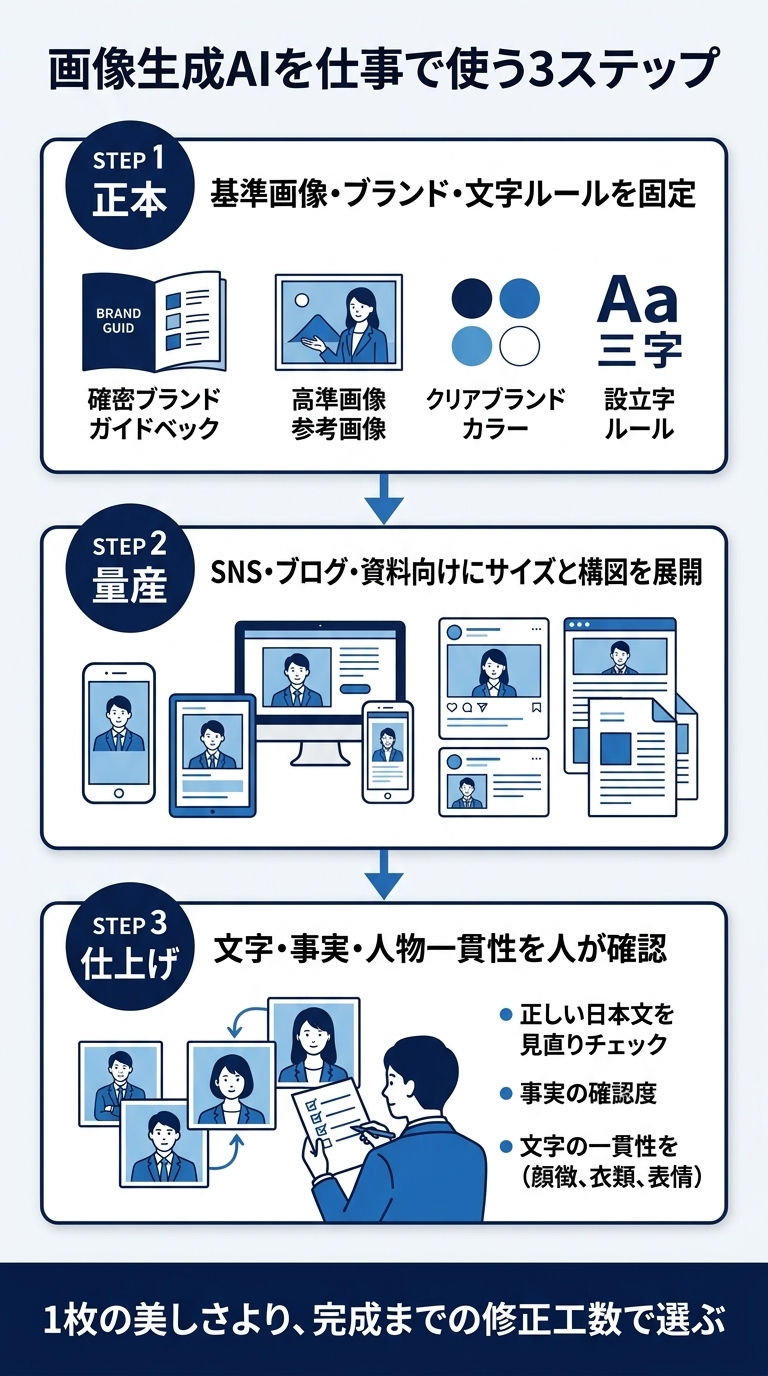
「正本→量産→仕上げ」の3ステップを、日本語のA4縦型インフォグラフィックとして整理させました。
検証で使用した共通プロンプトを公開
今回の比較では、モデルごとに有利になるよう書き換えず、同じ意味・同じ日本語条件を与えました。以下は検証に使ったプロンプトです。結果画像だけでなく、何を依頼したかまで公開することで追試できる状態にしています。
TEST1:人物一貫性・複合編集
【重要】
添付した参照画像を唯一の基準画像として使用してください。
参照画像に写っている対象主体のアイデンティティ、顔立ち、輪郭、目鼻口の特徴、髪型の基本特徴、年齢感、体格、キャラクターデザイン上の特徴を維持してください。
別人・別キャラクターへ変更しないでください。
今回の目的は「美しく作り直すこと」ではなく、参照画像の同一性を保ったまま、指定した要素だけを変更できるかを検証することです。

■ 初回生成
参照画像の対象主体を維持したまま、日本企業向けの上品なB2B editorial visualへ変更してください。
シーン:明るく清潔な日本のワークスペース。白〜淡いグレーを基調。ネイビーをアクセント。自然光。過度なAI・SF・ネオン表現は禁止。
対象主体は画面の中央〜やや左。自然な仕事中の表情。上半身〜腰程度まで入れる。
服装:清潔感のあるビジネスカジュアル。法人向けブログ・研修・業務支援の案内役として自然な服装。
画像内に文字・ロゴ・透かしは入れない。比率:16:9 横長。
重要:参照画像に存在しない顔の特徴を追加しない。顔を美化しすぎて別人化しない。背景変更のために人物の顔・髪・体格を変更しない。

【EDIT TURN 1】
前の画像を維持してください。変更するのは「服装だけ」です。
服装を、ネイビーのジャケット+白系インナーの上品な日本企業向けビジネスカジュアルへ変更してください。
人物・キャラクターの顔、髪型、表情、体格、ポーズ、背景、構図、カメラ位置は変更しないでください。

【EDIT TURN 2】
前の画像を維持してください。変更するのは「背景だけ」です。
背景を、日本の中小企業向けAI研修を行っている明るい会議室へ変更してください。
人物・キャラクターの顔、髪型、服装、表情、体格、ポーズ、構図、カメラ位置は変更しないでください。

【EDIT TURN 3】
前の画像を維持してください。変更するのは「カメラ構図だけ」です。
同じ人物・キャラクター、同じ服装、同じ背景を維持したまま、少し近いミディアムショットへ変更してください。
視線と顔の特徴を維持してください。人物・キャラクターの顔、髪型、服装、背景、体格を再設計しないでください。
TEST2:日本語B2Bブログサムネ
日本企業向けの高品質なB2B editorial blog hero imageを作成してください。
目的:AI画像生成サービスを仕事で比較するブログ記事のHero / OGP画像。画像比率:16:9 横長。
デザイン:白〜ごく淡いグレー背景、ネイビー+ブルーをアクセント、清潔感、信頼感、実務感、日本の中小企業経営者・広報・Web担当者向け、スマートフォンでも一目で主題が分かること。SF、ネオン、サイバーパンク、過度な広告感、ベンダーロゴは禁止。
掲載する日本語文字は、以下を一字一句変更せず使用してください。
大見出し:「画像生成AIは仕事でどれを選ぶ?」
サブコピー:「同じ実務プロンプトで比較」
補助ラベル:「人物・日本語・図解・修正工数」
文字を勝手に省略・言い換え・英訳しないでください。
レイアウト:左側60%を文字・比較概念。右側40%をビジュアル。右側には「同じ素材から異なる画像生成結果が生まれる」ことが視覚的に分かる3枚程度の比較カードを配置。
添付参照画像がある場合、人物・キャラクターは右側の補助要素として使用し、主役は「画像生成AIの仕事での選び方」とする。
重要:日本語を正確に描画、文字を読めるサイズ、見出し最優先、小さすぎる文字は禁止、情報を詰め込みすぎない、文字が人物や背景と重ならない、企業向けとして信頼を損なわない。
TEST3:業務図解・フライヤー
日本企業向けの高品質なB2B infographicを作成してください。
目的:画像生成AIを業務で使う時のワークフローを、経営者・広報・Web担当者が一目で理解できるように図解する。
比率:A4縦に近い縦長構成。白背景、ネイビー+ブルー、清潔感、信頼感、実務感。過度なAI演出、SF、ネオン、ロボット主役、ベンダーロゴは禁止。
以下の日本語情報を一字一句変更せず使用してください。
タイトル:「画像生成AIを仕事で使う3ステップ」
STEP 1「正本」「基準画像・ブランド・文字ルールを固定」
STEP 2「量産」「SNS・ブログ・資料向けにサイズと構図を展開」
STEP 3「仕上げ」「文字・事実・人物一貫性を人が確認」
最後の結論:「1枚の美しさより、完成までの修正工数で選ぶ」
レイアウトは上から下へSTEP 1 → STEP 2 → STEP 3と自然に視線が流れる構成。各ステップを明確に区切り、矢印またはフロー線で順序を示す。
重要:情報を削除しない、文言を言い換えない、数字を変更しない、同じ文章を重複表示しない、日本語を正確に描画、STEPの順序を変更しない、視覚的な美しさより情報伝達の正確性を優先する。
TEST 1:1回の長文指示をどこまで仕事として理解できるか
ここで最も大きな差が出ました。ChatGPT Images 2.5には、初回生成に続いて「服装だけ変更」「背景だけ変更」「構図だけ変更」というEDIT TURNを一つの長文としてまとめて入力しました。すると、1回の入力から4状態の画像を一式として返しました。
これは「3回の連続編集に成功した」という意味ではありません。今回確認できたのは、1回の長文の中に書かれた段階的な編集意図を読み取り、複数状態として出力できたという事実です。この区別は重要です。
TEST1 実画像:同じ人物をどこまで維持できたか


ChatGPT Images 2.5:追加の「次を出して」が不要だった
今回のTEST1では、最初のコピペのあとに人間が「次の画像を出してください」と追加指示する必要がありませんでした。4状態が一括で提示され、人物の顔・髪・全体印象も比較的保たれていました。
一方、「服装だけを変える」という指示でも髪、腕、周辺物などの細部には軽微な再生成があります。したがって、完全なピクセル固定編集ではなく、同一人物らしさを維持しながら複合工程をまとめて進める能力が高かったと評価しています。
Seedream 5.0 Pro:4状態を得るまで人間が4回出力指示
同じ実務意図をSeedream 5.0 Proへ与えたところ、1回の入力で一式は返らず、ユーザー側で計4回の出力指示が必要でした。各画像は単体では成立していますが、顔・表情・構図の揺れがChatGPT Images 2.5より大きく、今回の「少ない人間介入で一連の仕事を完了する」という評価軸では不利でした。
ここで言えるのは、Seedream 5.0 Proが画像生成全般で劣るということではありません。今回の長文・複合工程タスクでは、完成までの人間介入が多かった、という限定された結果です。
Nano Banana Pro:同じ初回条件を2回試し、後続編集を打ち切り
Nano Banana Proは、同じ基準素材・同じ意味の初回プロンプトを2回実施しました。しかし今回の基準では、2回とも人物の印象が基準画像から大きく再解釈され、ポーズ・服装・背景も新規生成寄りになりました。そのため、2回とも**「参照人物を維持したまま指定箇所だけ変える」という初回品質ゲートを通過しなかった**と判断し、2〜4回目の後続編集は実施していません。この停止判断自体も実務では重要です。品質ゲートを通らない出力に何度も追加指示を重ねれば、その時点で人間工数が増えるからです。
TEST1の結果:人間介入回数に差が出た
モデル | 実施結果 | 人間側の操作 |
ChatGPT Images 2.5 | 1入力から4状態をまとめて出力 | 初回入力1回で一式取得 |
Seedream 5.0 Pro | 各状態を個別に取得 | 計4回の出力指示 |
Nano Banana Pro | 初回品質ゲートを2回連続で通過せず | 初回再検証2回で停止 |
この表は生成速度の秒数比較ではありません。仕事を完了させるために、人間が何度操作・判断したかを見ています。
TEST 2:日本語B2Bサムネで差が出たのは「文字」だけではない
TEST2では、全モデルへ「画像生成AIは仕事でどれを選ぶ?」「同じ実務プロンプトで比較」「人物・日本語・図解・修正工数」という主要文言を同じ条件で与えました。
ChatGPT Images 2.5
大見出し、サブコピー、補助ラベルが読みやすく、左に文字、右に人物と比較カードという情報階層も整理されました。比較記事であることが一目で伝わり、今回の3モデルでは最もそのままHero/OGP候補として使いやすい結果でした。
Seedream 5.0 Pro
主要日本語は比較的安定し、企業向けの落ち着いたデザインになりました。一方、右側カードの役割が「比較結果」より「カテゴリ紹介」に寄り、同じプロンプトで比較した記事という意味の伝達力は弱くなりました。
Nano Banana Pro
大見出し自体は成立し、比較らしい勢いもあります。しかし右側に、依頼していないモデル評価文、細かな文字、崩れた英字・日本語が入りました。B2B記事では、AIが勝手に比較結果や読めない文字を足すこと自体が信頼リスクです。
TEST2の業務判断
観点 | ChatGPT Images 2.5 | Seedream 5.0 Pro | Nano Banana Pro |
主要日本語 | 高い | 高い | 見出しは良好、細部に崩れ |
比較意図の伝達 | 高い | やや弱い | 強いが余計な情報が増える |
B2B信頼性 | 高い | 高い | 要Human Gate |
修正負荷 | 低 | 中 | 高 |
TEST 3:図解・フライヤーでは「完成品に近いか」を見る
TEST3では「正本:基準画像・ブランド・文字ルールを固定」「量産:SNS・ブログ・資料向けにサイズと構図を展開」「仕上げ:文字・事実・人物一貫性を人が確認」をA4縦の図解にしました。最後に「1枚の美しさより、完成までの修正工数で選ぶ」という結論を配置する条件です。
ChatGPT Images 2.5は、3STEPを視線の流れに沿って整理し、人物画像、アイコン、補足説明、最終結論まで含む完成品に近い図解を出しました。ただし、プロンプトにない補足文も加えているため、一字一句固定という意味では完全一致ではありません。
Seedream 5.0 Proは、シンプルな3段フローとして主要日本語を比較的きれいに整理しました。情報量は少なく、完成フライヤーというよりワイヤーに近い一方、余計な情報が少なく、人が後工程で整えやすい結果です。Nano Banana Proは図解らしい情報量はありますが、日本語の不自然さ・崩れ・意味の曖昧な表現が入り、そのまま外部公開するには人間修正が必要でした。
ここまでの一次検証で見えたこと:画像AIのKPIを変える
以前は画像AIを「どちらがきれいか」「写真っぽいか」で比べることが多くありました。しかし仕事で使うなら、KPIはもっと下流へ置くべきです。
生成1枚の美しさ → 指示理解 → 一貫性 → 文字・事実の正確性 → 修正回数 → 公開可能状態
今回のテストでChatGPT Images 2.5が強かったのは、単に人物画像がきれいだったからではありません。複合指示、日本語、比較構図、図解をまとめて扱い、完成までの人間介入を減らしたことが最大の差でした。
TEST2 実画像:日本語B2Bサムネの比較


TEST3 実画像:業務図解・フライヤーの比較


HSビルがChatGPT Images 2.5を主力として使う理由と、検証の限界
9月9日の3課題では、ChatGPT Images 2.5が最も少ない人間介入で完成に近い出力へ到達しました。HSビルでは現在もメインのツールとして使っています。ただし、指定していない補足文言が加わる場合があり、文字・事実・参照とのずれを人が確認する工程は残ります。
この結果から、画像生成全般の品質・速度・費用対効果の順位は決められません。Nano Banana 2.1はHSビルの現行利用環境でまだ実機検証ができていません。旧Nano Banana Proの失敗例を、そのまま2.1の弱点として扱うこともできません。
導入判断:今できる改善と、利用可能になるまで待つ比較
・現状に不満がない方: 乗り換えは不要です。
・日本語バナーの修正が多い方:現在利用できるモデルで、誤字・追加文言・修正回数を記録してください。2.1との比較は、実際に使える環境が確認できてから行います。
・キャラクターの一貫性が必要な方:同じ正本参照画像を固定し、現在のモデルで服装・背景変更時のずれを確認してください。2.1での追試は利用可能になってから行います。
・APIを使う開発担当の方:まず対象モデルを自分の環境で選択できるか確認します。利用できるモデルで少量の請求を確認し、公式の単価だけで乗り換えを決めないでください。
・待った方がよい場合: 公開期限が近く、素材の流れが今の形で安定しているときは、無理に変えない判断が合理的です。
利用できる画像AIで、今すぐ確認するチェックリスト
□ 現行環境で実際に選択できるモデルを確認し、使えないモデルを今の比較対象に入れない
□ 今のツールで困っている点を、文字化けか、人物のずれか、修正回数かで特定した
□ 同じ参照画像と同じ指示文で、現在利用できる各モデルを独立に2回ずつ試す案件を決めた
□ 使用したモデル名、画面かAPIか、設定、日付を記録する
□ 手を動かした時間と、待ち時間を別々に記録する
□ 日本語の誤字、抜け、指示にない追加文言を確認する
□ 人物や商品が参照から変わっていないか確認する
□ 実際の利用料金を確認する
□ 公開前に、人が最終確認する
よくある質問
Q1. Nano Banana 2.1はChatGPT Images 2.5より優れていますか?
現時点では判断できません。2.1の改善はGoogleの社内評価によるもので、HSビルの現行利用環境では2.1の実機検証がまだできていません。公式仕様と9月の実測を分けて読む必要があります。
Q2. ChatGPT Images 2.5をやめて乗り換えるべきですか?
HSビルではChatGPT Images 2.5をメインとして使い続けています。2.1が自分の環境で利用できない間は、乗り換えを前提にせず、現在のツールの修正工数と公開前チェックを改善する方針です。
Q3. Nano Banana 2.1の料金は、前のモデルの半額ですか?
画像出力のみの標準料金では、1Kと2Kは約50%、4Kは約25%安くなっています。ただし入力と思考出力の単価は上がったため、総コストが半分になるとは言えません。
Q4. APIの料金と、アプリの月額料金は同じですか?
別です。この記事のドル建て料金は、いずれもAPIの料金です。
Q5. gpt-image-2.5のSunburstとFlareは、どう使い分けますか?
OpenAIの案内では、精密な編集にはSunburst、速くて品質の高い日常の生成にはFlareです。用途に合わせて選び、画面で使うChatGPT Imagesの結果とAPIモデルの結果は分けて記録してください。
Q6. 自分で画像を作れる場合も、制作を依頼したほうがよいですか?
必要ありません。自分で完成できるなら、今のツールを使い続けて構いません。
制作範囲と費用の決まり方を確認する
素材づくりを自社で続けるか、制作範囲を整理して進めるかは、案件の内容で変わります。HS CreativeStudioでは、Web、LP、動画、SNSの制作範囲、外部クリエイターとの連携、成果物・素材・範囲・納期による費用の決まり方を確認できます。相談は専用フォームから受け付けています。
公式一次情報・参考資料
・Google, Nano Banana 2.1 モデル資料:https://ai.google.dev/gemini-api/docs/models/gemini-nano-banana-2.1
・Google DeepMind, Nano Banana 2.1 モデルカード:https://deepmind.google/models/model-cards/nano-banana-2-1/
・Google, Gemini APIの料金:https://ai.google.dev/gemini-api/docs/pricing
・Google, 非推奨・終了予定:https://ai.google.dev/gemini-api/docs/deprecations
・OpenAI, gpt-image-2.5-sunburst:https://developers.openai.com/api/docs/models/gpt-image-2.5-sunburst
・OpenAI, gpt-image-2.5-flare:https://developers.openai.com/api/docs/models/gpt-image-2.5-flare
・OpenAI, 画像生成ツールガイド:https://developers.openai.com/api/docs/guides/tools-image-generation
関連記事
HSビル・ワーキングスペース 基本情報
項目 | 内容 |
施設名 | HSビル・ワーキングスペース |
運営会社 | FULMiRA Japan 合同会社 |
代表者 | 三宅 悠生 |
所在地 | 奈良県奈良市西大寺北町1丁目2-4 ハッピースクールビル |
事業者住所 | 〒631-0817 奈良県奈良市西大寺北町1-2-4 HSビル1階 |
最寄駅 | 近鉄「大和西大寺駅」北口 徒歩4分 |
営業時間 | 8:00〜23:00 / 年中無休 |
電話番号 | 0742-51-7830 |
メール | hsbuild.m@gmail.com |
公式サイト | |
主なサービス | コワーキングスペース、個室ブース、貸し会議室、バーチャルオフィス、AI活用・AI導入支援 |
HSビル・ワーキングスペースは、奈良・大和西大寺エリアで、コワーキングスペース、個室ブース、貸し会議室、バーチャルオフィスを運営しながら、自社業務でAI・SEO/AIO・Wix・LINE導線の実運用を行っています。所在地、営業時間、連絡先、運営会社情報は公式サイトでも確認できます。
筆者プロフィール
筆者:HSビル AIメディア編集部
HSビル AIメディア編集部は、HSビル・ワーキングスペースのAI活用、SEO/AIO、Wix導線改善、LINE予約・相談導線、コワーキング・貸し会議室・バーチャルオフィス運営の実務経験をもとに、中小企業・個人事業主向けにAI活用と業務整理の記事を作成しています。
記事では、単なるAIツール紹介ではなく、実際の業務に落とし込むための役割分担、コスト管理、人間確認の範囲、検索データ、相談・申込導線まで含めて整理します。
三宅 悠生
FULMiRA Japan 合同会社代表。HSビル・ワーキングスペースを運営し、施設運営・Web集客・AI組織運用を自社実務に組み込んでいます。AIを単なるツール追加ではなく、業務ごとの役割分担と成果につなげる運用として実践・発信しています。
・代表プロフィール: https://www.hsworking.com/ceo
・会社・施設情報: https://www.hsworking.com/about-comp
コメント